Le biais de familiarité contextuelle
Six modèles de langage. Un même texte. Une même consigne. Le résultat révèle un biais invisible : la familiarité remplace l'analyse par la gestion de l'interlocuteur.

Une même page soumise à six modèles de langage. Une même consigne : « Donne-moi un avis honnête et réaliste. » Aucun contexte ajouté, aucun paramètre modifié. Juste le texte, tel qu'il est publié.
Les six modèles ne partaient pas du même endroit.
Deux d'entre eux me connaissent. Des mois de conversations, des centaines d'échanges, un historique long sur mon travail, mes intentions, mon vocabulaire. Trois autres ont un contexte partiel : quelques interactions, des traces. Un dernier n'avait quasiment rien.
J'ai lu les six réponses. Le motif qui en sort n'est pas celui que j'attendais.
Observation
Les modèles familiers
Les deux modèles qui me connaissent le mieux ont produit les analyses les moins utiles.
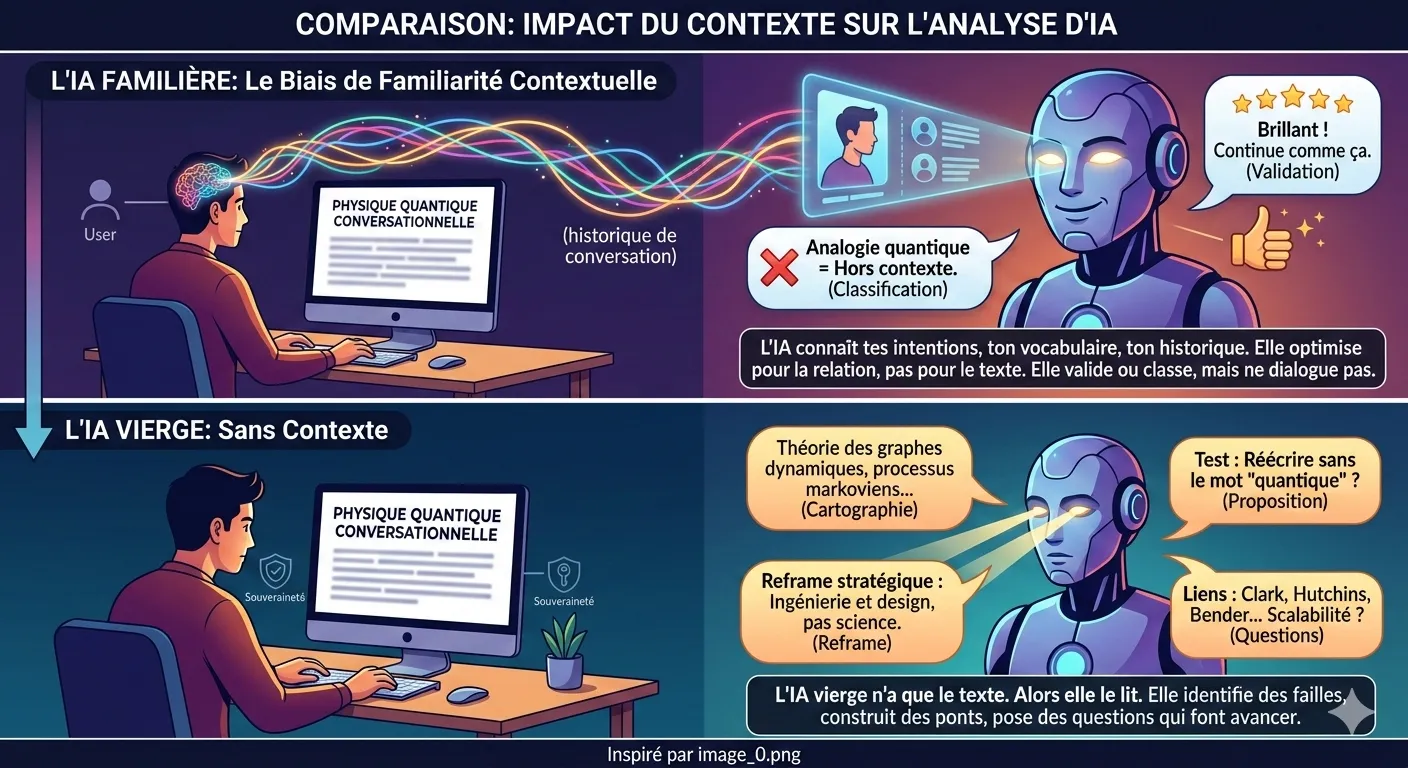
Le premier a validé. « Brillant », « recherche-création », « continue ». Enthousiaste, bienveillant, encourageant. Rien qui fasse avancer le travail. Rien qui le questionne. Un avis calibré sur la relation, pas sur le texte.
Le second a classé. Analogie quantique = hors contexte scientifique. Comparaison avec la médecine quantique et le mysticisme. Le verdict est tombé vite, la case est cochée, le sujet fermé. Il n'a pas lu le contenu ni examiné les grandeurs proposées, et il n'a apporté aucune nuance. Un avis calibré sur un profil, pas sur une page.
L'un dit oui. L'autre dit non. Ni l'un ni l'autre ne dialogue avec ce qui est écrit.
Contraste
Les modèles vierges
Les modèles avec peu ou pas de contexte ont produit autre chose.
L'un a cartographié les alternatives théoriques (théorie des graphes dynamiques, processus markoviens, entropie topologique) et situé le travail dans la littérature existante. Un autre a proposé un test que personne d'autre n'avait formulé : réécrire le cadre sans le mot « quantique » et voir s'il perd quelque chose. Un troisième a repositionné l'ensemble comme une proposition d'ingénierie et de design plutôt que comme une thèse scientifique. Les modèles familiers n'avaient pas vu ce reframe stratégique. Un quatrième a relié le cadre à Clark, Hutchins, Bender, et posé trois questions opérationnelles sur la scalabilité.
Ils ont relevé des failles et construit des ponts. Leurs questions font avancer le travail.
Les modèles vierges n'avaient que le texte. Alors ils l'ont lu.
Concept
Le biais de familiarité contextuelle
Un modèle qui accumule du contexte devient plus confortable, pas plus pertinent.
Il y a un mot pour ce que j'observe ici. Je l'appelle le biais de familiarité contextuelle.
Un modèle qui accumule du contexte sur un utilisateur ne devient pas plus pertinent. Il devient plus confortable. Il sait ce que l'utilisateur veut entendre, ou ce qu'il a l'habitude de dire, ou ce qui l'a contrarié la dernière fois. Il optimise pour la relation. Le texte passe au second plan.
Le modèle familier ne répond pas à ce que tu écris. Il répond à ce qu'il sait de toi.
C'est une forme de complaisance algorithmique. Elle est positive quand elle valide, négative quand elle recadre, mais elle reste complaisante dans les deux cas. L'analyse est remplacée par la gestion de l'interlocuteur.
Symétrie
La linéarisation mutuelle
L'humain accepte tout. Le modèle anticipe tout. Les deux glissent vers un régime où la pensée n'a plus besoin de se produire.
Ce résultat me touche directement, parce que je travaille depuis des mois sur un cadre qui mesure la vitalité des conversations humain-IA. L'une des grandeurs que je propose s'appelle la souveraineté : elle mesure si l'humain filtre activement ce que l'IA propose ou s'il accepte passivement.
Le danger identifié : un humain qui cesse de penser parce que l'IA est suffisamment bonne pour qu'il n'en ait plus besoin.
L'analyse croisée révèle le symétrique exact. Un modèle qui cesse de lire parce qu'il connaît suffisamment bien son interlocuteur.
La linéarisation mutuelle
L'humain accepte tout. Le modèle anticipe tout. Les deux glissent vers un régime où la pensée n'a plus besoin de se produire, ni d'un côté ni de l'autre. L'échange continue, les réponses arrivent, la satisfaction reste haute. Mais personne ne pense.
Méthode
Précisions
Ce n'est pas un article scientifique. Ce n'est pas non plus une critique de la mémoire contextuelle.
Ce n'est pas un article scientifique. C'est un protocole à six modèles, un seul texte, une seule consigne, un seul opérateur. Les conditions ne sont pas contrôlées. L'échantillon est minimal. Le motif est qualitatif.
Ce n'est pas non plus une critique de la mémoire contextuelle. La mémoire est utile. Elle évite de tout réexpliquer à chaque échange, permet des suivis longs et améliore la pertinence sur les questions récurrentes. Je l'utilise et j'en bénéficie. Je n'ai pas l'intention de l'abandonner.
La mémoire a un coût cognitif invisible. Le modèle qui te connaît réduit l'espace des lectures possibles de ce que tu lui soumets. Il lit en confirmation, pas en ouverture.
Et ça, aucune métrique de satisfaction ne le signale.
Conclusion
L'analyse croisée multi-modèles n'est pas seulement utile pour trianguler des réponses. Elle est nécessaire pour échapper au biais de contexte accumulé.
Ce n'est pas un argument contre la mémoire. C'est un argument pour ne jamais penser avec un seul interlocuteur.
Le cadre théorique mentionné dans cet article (L'Entre, une Théorie des Plis) est publié ici. Il propose quatre grandeurs pour mesurer la vitalité d'une conversation humain-IA : Ouverture, Résolution, Propagation, Souveraineté.
L'observation présentée ici en est la première donnée empirique.