Architecture
KAIROS
Vue d'ensemble technique
Comment le cadre de L'Entre — Théorie des Plis — devient un logiciel de cartographie cognitive : architecture, jauge Oxygène, friction, souveraineté. Document vivant, sans DOI.
Abstract
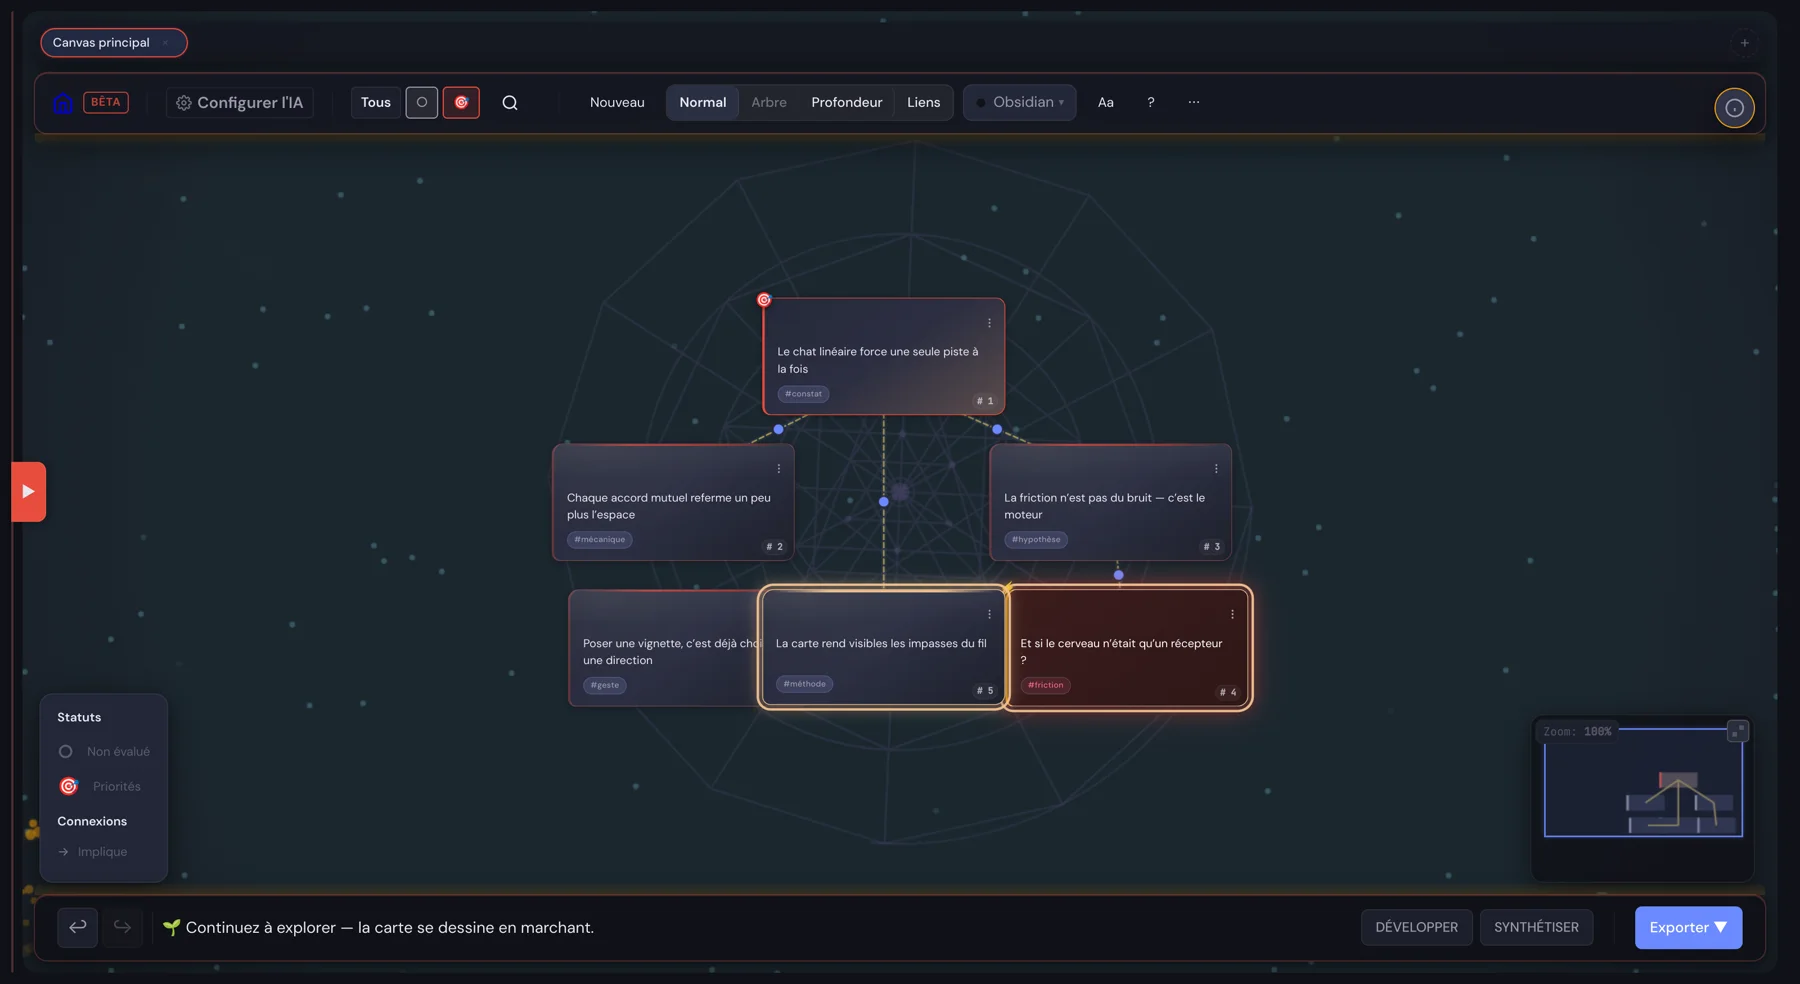
KAIROS est une application de bureau (Electron) qui transforme l'exploration d'idées en cartographie spatiale non-linéaire, assistée par intelligence artificielle. Contrairement aux interfaces conversationnelles linéaires (chat), KAIROS représente les concepts comme des vignettes positionnées sur un canvas 2D, reliées par des connexions typées (implication, résonance, conflit, exemple).
Le système intègre une jauge d'oxygène cognitive (O₂) : un score snapshot 0–100, un triangle radar (divergence, cohérence, souveraineté) et un diagnostic de contenu par embeddings locaux. Un mécanisme de friction détecte les circularités et injecte une perturbation quand la pensée s'asphyxie. Autour du canvas : mode Autonome, Companion, Mode Gardien, import de sources.
L'application s'appuie sur le cadre de L'Entre — Théorie des Plis. Les deux ne coïncident pas formule pour formule : O₂ a été construit avant la version actuelle de l'équation ET. Ils s'informent ; ils ne sont pas le même objet. TypeScript vanilla, pas de framework UI, SQLite embarqué, suite de tests unitaires.
Problème : la linéarisation mutuelle
L'interface chat comme réducteur cognitif
L'interface conversationnelle séquentielle (chat) impose une linéarisation structurelle à la pensée exploratoire. Chaque tour de parole écrase la simultanéité des idées en une séquence ordonnée.
Appauvrissement cognitif — Klein & Klein (2025) montrent que l'interaction prolongée avec l'IA érode les connaissances fondationnelles, l'utilisateur déléguant progressivement les opérations de structuration.
Amplification des biais — Glickman & Sharot (2024) mesurent une augmentation de 15 à 25% des biais perceptuels, émotionnels et sociaux dans les boucles de rétroaction humain-IA.
Dette cognitive — Kosmyna et al. (2025, MIT Media Lab) observent une réduction de 55% de l'activité cérébrale lors de la rédaction assistée par ChatGPT, suggérant un désengagement cognitif structurel.
L'accordage passif
Au-delà de la linéarisation, les interfaces conversationnelles produisent un accordage passif : l'utilisateur s'aligne progressivement sur le registre, le rythme et les catégories de l'IA. Ce phénomène correspond, dans L'Entre, à une pression P qui se resserre sans qu'on l'ait décidé — convergence vers ce que le fil contient déjà.
Hypothèse de KAIROS
La spatialisation non-linéaire des idées, combinée à des mécanismes de friction et à une mesure continue de la souveraineté, peut maintenir l'engagement actif de l'utilisateur dans l'exploration assistée par IA. Le score O₂ rend visible ce qui est habituellement invisible : la qualité structurelle de la pensée en cours.
Architecture
Stack technique
| Composant | Technologie | Détail |
|---|---|---|
| Runtime | Electron 28 | Processus main + renderer, Node 18 embarqué |
| Langage | TypeScript (ES modules) | Aucun framework UI — DOM + événements custom |
| Bundler | Vite 7 | Multi-page, esbuild (pas de tsc emit) |
| Base de données | SQLite (better-sqlite3) | WAL mode, persistence par canvas |
| Stockage clés | electron-store + safeStorage | Chiffrement natif OS |
| Visualisation | Canvas 2D + SVG | Fond génératif, connexions organiques, radar |
| Page d'accueil | Three.js | Icosaèdre 3D |
| Embeddings | Ollama + bge-m3 | Diagnostic contenu local, hors score |
| Tests | Vitest | Suite unitaire lancée hors Electron |
Sécurité : nodeIntegration: false, contextIsolation: true. Les clés API ne transitent jamais en clair via IPC (le renderer envoie une référence, le main process résout via safeStorage). CSP centralisé dans le processus principal.
Deux modes d'exploration
| Mode Assisté | Mode Autonome | |
|---|---|---|
| Accent visuel | Rouge / orange | Violet / mauve |
| Rôle de l'IA | Opérations structurées | Dialogue non-directif |
| Opérations | DÉVELOPPER, RELIER, SYNTHÉTISER, PERSPECTIVES | Chat libre, Prompt Lab, cartes d'émergence |
| Friction | Injection automatique (O₂ < 30) | Pas d'injection |
| O₂ | Actif — score, triangle, bandeau | Passif — observation, pas de guidage |
| Providers | Roster complet, tous modes | |
Claude, ChatGPT, DeepSeek, Mistral, Groq, Grok, Ollama. Coller une clé API suffit : le fournisseur est détecté automatiquement. Ollama tourne en local, sans clé.
Canvas spatial
Chaque vignette est un nœud positionné dans un espace 2D continu :
- ID :
n_{crypto.randomUUID()}— jamaisDate.now()(collisions SQLite, rollback complet) - Statut :
neutraloupriority(ancres, maximum 3 par canvas) - Tags : dimensions transversales
- Origine :
user,llm,frictionouimport
Les connexions sont typées : implies (→), resonance (↔), conflicts, example.
Cette spatialisation permet de voir la structure de la pensée : un arbre descendant se distingue d'un graphe à boucles. O₂ quantifie cette distinction.
Système Oxygène (O₂)
Scoring cognitif temps réel, snapshot pur : recalculé de zéro à chaque évaluation, sans accumulation. Score par défaut (canvas vide) : 50.
Formule actuelle
score = 50
      + structure      (Signal 1 : -25 à +5, modulé par le régime cognitif)
      + friction       (Signal 5 :   0 à +10)
      + convergence    (Signal 6 :   0 à +15, optionnel)
      + topologiques   (Signal 7 :  -8 à +20)

score = score × (0.70 + 0.30 × triangleHealth)
score = clamp(0, 100)
score = min(score, plafond contenu)   ← si pathologie sémantique, sauf régime Approfondissement sans écho
Ce qui n'entre plus dans le score : la diversité des tags (Signal 4, informatif seulement — les tags sont trop souvent générés par le LLM) et l'offset de posture (Signal 8, à 0 pour toutes les postures, puis le système de postures a été retiré).
Trois zones :
- Respire (> 50) : exploration libre
- Stagne (30–50) : force le sous-mode diverger
- Asphyxie (< 30) : injection automatique d'une friction
Signaux structurels (dans le score)
Structure (activé ≥ 4 vignettes) : ratio connexions / vignettes. Sous-connecté (< 0.5) ou sur-connecté (> 3) : malus −25. Équilibré (1–2) : +5. Îlots déconnectés : −5 par composante supplémentaire, atténué selon le régime cognitif. Rampe d'activation pour éviter un cliff à 4 nœuds.
Friction : accepter une vignette friction donne +10 pendant un tour.
Convergence : bonus optionnel +5 à +15 si une analyse Perspectives a été produite.
Grandeurs topologiques (dans le score)
| Grandeur | Activation | Mesure | Bonus |
|---|---|---|---|
| Ouverture (ψ) | ≥ 4 nœuds | Ratio de nœuds sans implies sortant | −3 à +5 |
| Résolution | ≥ 6 nœuds | Nœuds avec implies entrant et sortant | 0 à +5 |
| Propagation | ≥ 6 nœuds | Plus longue chaîne implies | 0 à +5 |
| Souveraineté (◉) | ≥ 1 nœud LLM | Ratio nœuds utilisateur / total | −5 à +5 |
La souveraineté du triangle utilise un ratio enrichi : 50% nœuds manuels + 25% connexions manuelles + 25% nœuds LLM ou friction édités. Contribution topologique totale au score : −8 à +20.
Triangle radar (poids fixes)
Trois axes hybrides 0–100, chacun = 70% snapshot + 30% dynamique :
| Axe | Snapshot (70%) | Dynamique (30%) |
|---|---|---|
| Divergence (ψ) | ouverture.ratio × 100 | motilité |
| Cohérence (») | min((chaîne−1)/4, 1) × 100 | normalizeDeltaP(ΔP) |
| Souveraineté (◉) | enrichedRatio × 100 | taux de conversion |
Les poids du triangle sont fixes (divergence 0.35, cohérence 0.35, souveraineté 0.30). Plus de redistribution par posture. Un geste ponctuel « Sans Filtre » change le ton d'une génération, pas le calcul du score.
triangleHealth module le score : un triangle déséquilibré peut le réduire de 30% au maximum. ΔP (respiration) mesure si le graphe s'approfondit ou se replie ; normalisation asymétrique — expansion linéaire, contraction quadratique.
Régime cognitif
Un module séparé infère la phase (Exploration, Approfondissement, Synthèse, Inconnu) à partir de la motilité, de la densité de cluster embedding, des îlots et de l'écho. Il module deux choses seulement : le malus d'îlots (attendu en exploration) et le plafond de contenu (relâché en approfondissement, sauf si l'écho signale aussi de la paraphrase).
Diagnostic contenu (hors score, peut plafonner)
Trois signaux sémantiques, calculés par embeddings locaux (bge-m3 via Ollama), pas par recouvrement de tags ni thésaurus :
- Écho — similarité cosinus ≥ 0.6 entre paires de vignettes. −5 / paire (plafond −50).
- Saturation — parmi les paires connectées, cosinus ≥ 0.65. Ratio > 50% → malus virtuel −10 à −20.
- Concentration — clustering (seuil 0.55). Plus gros cluster > 60% → −10 virtuel ; ≤ 35% → +10 virtuel.
Si le malus virtuel total ≤ −25 (sévérité warning), le score est plafonné (75 / 65 / 55 selon la gravité), sauf le cas d'approfondissement réel décrit plus haut. Un canvas saturé n'affiche pas 95.
Friction
Deux mécanismes distincts, souvent confondus : le score O₂ (asphyxie → vignette friction) et le score de circularité (injection dans le prompt).
Circularité (6 signaux)
| Signal | Détection | Poids |
|---|---|---|
| Reformulation | Similarité sémantique entre vignettes | Élevé |
| Cycles | Cycle dirigé dans le graphe (DFS) | Élevé |
| Stagnation | Tours sans nouveau concept | Moyen |
| Validation vide | « ok », « oui », « très bien » | Faible |
| Tags saturés | Un tag > 5 occurrences | Moyen |
| Écho LLM | Sortie trop proche de l'entrée | Moyen |
Seuils fixes (plus de réglage par posture) : friction modérée au-dessus de 50, radicale au-dessus de 30. Un cooldown empêche l'injection à chaque tour. Le geste Sans Filtre n'agit pas sur ces seuils : il pousse le ton de la prochaine génération DÉVELOPPER / RELIER, une fois, puis s'éteint.
Injection et vignettes friction
Friction modérée : « évite les reformulations / mécanismes déjà présents ». Radicale : listes explicites de mots-clés et de mécanismes à éviter.
Sous O₂ < 30, le système peut aussi poser une vignette [FRICTION] (halo rouge). La garder : +10 O₂ pendant un tour. La supprimer : pas de malus. L'éditer : compte comme appropriation (souveraineté).
Génération dégressive
Plus le canvas mûrit, moins l'IA génère. DÉVELOPPER propose d'abord plusieurs vignettes, puis deux, puis une seule ciblée. L'IA s'efface quand la pensée se structure.
Traçabilité
Dans les prompts, les vignettes manuelles récentes sont marquées [USER·NEW], les plus anciennes [USER] (« construis dessus, ne la reformule pas »), les vignettes IA éditées [EDITED]. Le LLM doit pouvoir distinguer la direction de l'utilisateur du matériel qu'il a lui-même produit.
Autour du canvas
Mode Gardien
Filet cognitif, pas un contrôle. Il observe des patterns (souveraineté basse, angles morts, tension manquante), tient un journal, et — quand un insight LLM est déclenché — ancre le texte sur des vignettes réelles, citées. Deux gestes actionnables apparaissent dans le journal seulement quand un signal les justifie : Explorer et Sans Filtre. Rien n'agit de façon invisible.
Companion
Chat libre, fenêtre séparée, indépendant du canvas. Pour clarifier une idée sans structurer le graphe. Recherche web optionnelle (Ollama + Tavily), à portée locale, désactivée par défaut.
Import de sources
Fichiers, PDF, URLs : résumés automatiquement (Ollama) et posés comme vignettes origin:'import'. Le texte intégral n'est jamais injecté dans un prompt — seul le résumé l'est.
Perspectives
Analyse de convergence indépendante : graphe actif, synthèse archivée, ou sélection. Fil rouge, leviers d'action, tensions. Distinct de SYNTHÉTISER (lecture en trois blocs : fil rouge, angles morts, question structurelle).
État actuel
Fournisseurs LLM
| Fournisseur | Type | Timeout |
|---|---|---|
| Claude (Anthropic) | Cloud | 30s |
| ChatGPT (OpenAI) | Cloud | 30s |
| DeepSeek | Cloud | 30s |
| Mistral | Cloud | 30s |
| Groq | Cloud | 30s |
| Grok (xAI) | Cloud | 30s |
| Ollama | Local | 240s |
Tous disponibles dans tous les modes. Champ de détection automatique : coller une clé, le provider s'active. Ollama est spawné à la demande (pas de service système permanent), avec keep_alive: 30s pour libérer la VRAM. Modèles Ollama testés : qwen3:14b (prioritaire), qwen3:8b, gemma3:4b. Embeddings : bge-m3, séparé du chat.
Ce qui est en place
- Jauge O₂ snapshot, triangle radar, régime cognitif, embeddings contenu
- Friction automatique, génération dégressive, bandeau de suggestion
- Quatre opérations assistées + mode Autonome (Prompt Lab, cartes d'émergence)
- Mode Gardien, Companion, import de sources
- Multi-canvas, 4 thèmes (Obsidian, Porcelain, Aurora, Kraft), onboarding progressif
- Build Linux (AppImage) et Windows ; macOS non publié. La bêta publique est en finalisation — le téléchargement est temporairement fermé.
Ce que ce n'est pas
O₂ n'isole pas O, Δ, P et R comme quatre calculs distincts. L'équation ET de L'Entre est un cadre plus récent que le score. Faire coïncider les deux demanderait une refonte, pas un ajustement — c'est dit aussi dans la thèse.
Fondements théoriques
KAIROS s'appuie sur L'Entre et, en amont, sur un socle d'analyse conversationnelle et de psychologie cognitive.
Friction productive — Le conflit socio-cognitif (Doise & Mugny, 1984 ; Butera, Sommet & Darnon, 2019) : le désaccord épistémique force à décentrer. La friction de KAIROS est conçue dans ce registre : elle ne prescrit pas quoi penser, elle force l'exploration hors des attracteurs locaux.
Réparation conversationnelle — Schegloff, Jefferson & Sacks (1977) : les participants détectent et corrigent les malentendus. KAIROS automatise une forme de cette détection et injecte des contraintes dans le prompt.
Linéarisation — Schiffrin (1987), Fraser (1999), Mann & Thompson (1988) : la mise en séquence impose une hiérarchie artificielle. La spatialisation 2D contourne cette contrainte.
Alignement — Pickering & Garrod (2004), Clark & Brennan (1991) : la convergence des cadres. En interaction humain-IA, le risque est l'alignement passif. L'axe Souveraineté rend cette dérive mesurable.
Références
Travaux de l'auteur
Klimacek, F. (2026). L'Entre — Théorie des Plis. https://doi.org/10.5281/zenodo.19023026
Études empiriques récentes
Glickman, M. & Sharot, T. (2024). How human–AI feedback loops alter human perceptual, emotional and social judgements. Nature Human Behaviour, 9, 345–359.
Klein, C. R. & Klein, R. (2025). The extended hollowed mind: why foundational knowledge is indispensable in the age of AI. Frontiers in Artificial Intelligence, 8, 1719019.
Kosmyna, N. et al. (2025). Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task. MIT Media Lab. arXiv:2506.08872
Analyse conversationnelle et conflit
Schegloff, E. A., Jefferson, G. & Sacks, H. (1977). The preference for self-correction in the organization of repair in conversation. Language, 53(2), 361–382.
Doise, W. & Mugny, G. (1984). The Social Development of the Intellect. Pergamon Press.
Butera, F., Sommet, N. & Darnon, C. (2019). Sociocognitive conflict regulation. Current Directions in Psychological Science, 28(2), 145–151.
Pickering, M. J. & Garrod, S. (2004). Toward a mechanistic psychology of dialogue. Behavioral and Brain Sciences, 27(2), 169–226.
Clark, H. H. & Brennan, S. E. (1991). Grounding in communication. In Perspectives on Socially Shared Cognition. APA.
Fraser, B. (1999). What are discourse markers? Journal of Pragmatics, 31(7), 931–952.
Mann, W. C. & Thompson, S. A. (1988). Rhetorical Structure Theory. Text, 8(3), 243–281.
Schiffrin, D. (1987). Discourse Markers. Cambridge University Press.
État du logiciel au 22 août 2026. Document vivant, sans DOI. Les constantes O₂ citées ici sont celles du guide interne vérifié contre le code (formule snapshot, embeddings bge-m3, poids du triangle fixes).